การใช้งาน Home Assistant บน Proxmox ในมินิพีซีควบคู่ไปกับบริการอื่นๆ อีกหลายอย่างนั้นถือเป็นการตั้งค่าที่แข็งแกร่ง แต่การใช้โมเดลภาษาขนาดใหญ่ (LLM) ในเครื่องผ่าน Ollama นั้นโดยทั่วไปแล้วช้าเกินไปหรือไม่แม่นยำพอที่จะเป็นประโยชน์สำหรับผู้ช่วยเสียง Home Assistant มีผู้ช่วยเสียงในตัวที่เรียกว่า Assist โดยค่าเริ่มต้นแล้ว จะใช้ชุดประโยคและเจตนาที่กำหนดไว้ล่วงหน้าเพื่อแปลงคำสั่งเสียงเป็นการกระทำ ตัวอย่างเช่น การพูดว่า "เปิดไฟอ่านหนังสือ" จะตรงกับรูปแบบของการturn_onกระทำ ทำให้ไฟเป้าหมายเปิดขึ้นภายในเวลาไม่ถึงหนึ่งวินาที
: ภาพประกอบบทความ
อย่างไรก็ตาม การก้าวออกนอกขอบเขตคำสั่งที่กำหนดไว้ล่วงหน้าอย่างจำกัดนี้ จะทำให้ Assist ทำงานล้มเหลว การกด "ปิดอีกครั้ง" จะทำให้เกิดข้อผิดพลาด เนื่องจาก Assist ไม่รู้จัก "it" ว่าเป็นการอ้างอิงเอนทิตีที่ถูกต้อง การเชื่อมต่อ Assist กับบริการบนคลาวด์ เช่น OpenAI จะช่วยแก้ปัญหานี้ได้ แต่จะส่งคำสั่งและข้อมูลไปยังเซิร์ฟเวอร์ของบุคคลที่สาม การเชื่อมต่อ Assist กับ LLM ในเครื่องจะช่วยรักษาข้อมูลให้เป็นส่วนตัว แต่ข้อจำกัดของฮาร์ดแวร์มักส่งผลให้ความเร็วไม่เป็นที่ยอมรับ
ทดสอบ Qwen 3.5 4B
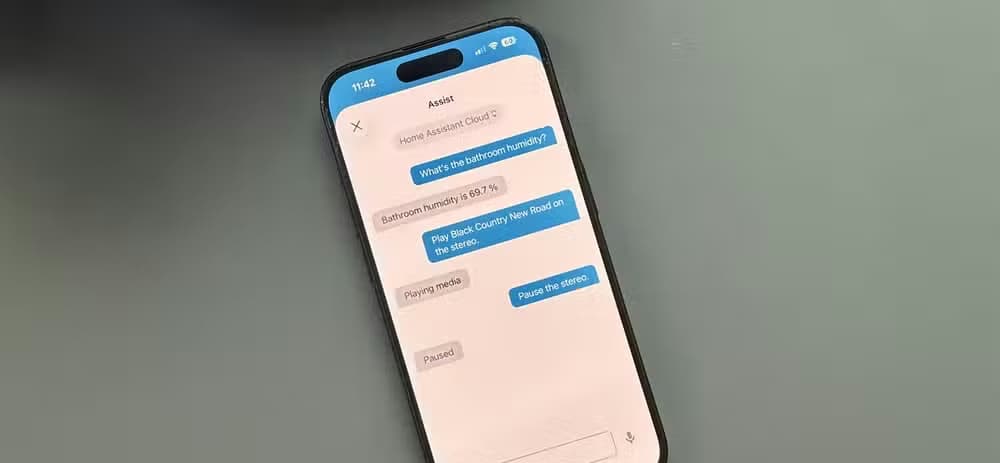
การทดสอบเริ่มต้นด้วย Qwen 3.5 4B ซึ่งเป็นรุ่นที่มีประสิทธิภาพพอสมควรและมีขนาดเล็กพอที่จะใช้งานได้ในพื้นที่ การทดสอบเบื้องต้นตรวจสอบว่าสามารถเปิดไฟและตอบสนองต่อคำสั่ง "ปิดอีกครั้ง" ได้หรือไม่ แม้ว่า Qwen 3.5 จะทำงานได้อย่างถูกต้อง แต่ก็ใช้เวลาถึงห้าวินาทีก่อนที่อะไรจะเกิดขึ้น ซึ่งช้าเกินไปสำหรับการควบคุมด้วยเสียงในทางปฏิบัติ
: แอปผู้ช่วยเสียง Assist ของ Home Assistant ที่ทำงานบน iPhone
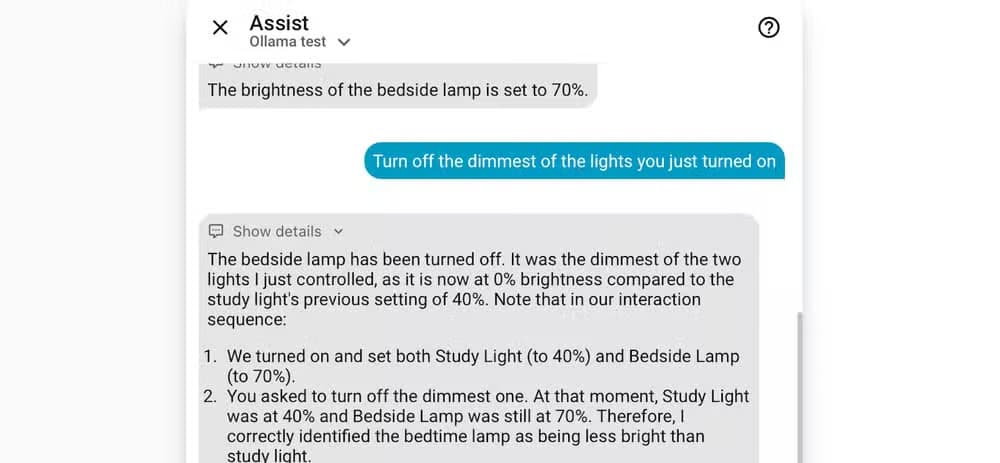
เมื่อได้รับคำสั่งที่ซับซ้อนมากขึ้นซึ่งมีหลายขั้นตอน Qwen 3.5 ก็สามารถทำตามคำสั่งที่สี่ได้สำเร็จ อย่างไรก็ตาม เมื่อถูกขอให้ปิดไฟดวงที่สว่างน้อยที่สุดซึ่งเพิ่งเปิดไป มันกลับปิดโคมไฟข้างเตียงซึ่งสว่างกว่าอีกดวงหนึ่ง มันทั้งช้าและไม่แม่นยำ
: Qwen 3.5 4B ทำงานผิดพลาดเมื่อได้รับคำสั่งให้ปิดไฟที่สว่างน้อยที่สุด โดยเลือกตัวเลือกผิดในแอป Assist บน Home Assistant
การประเมินผล Llama 3.2 3B และ Nemotron Mini 4B
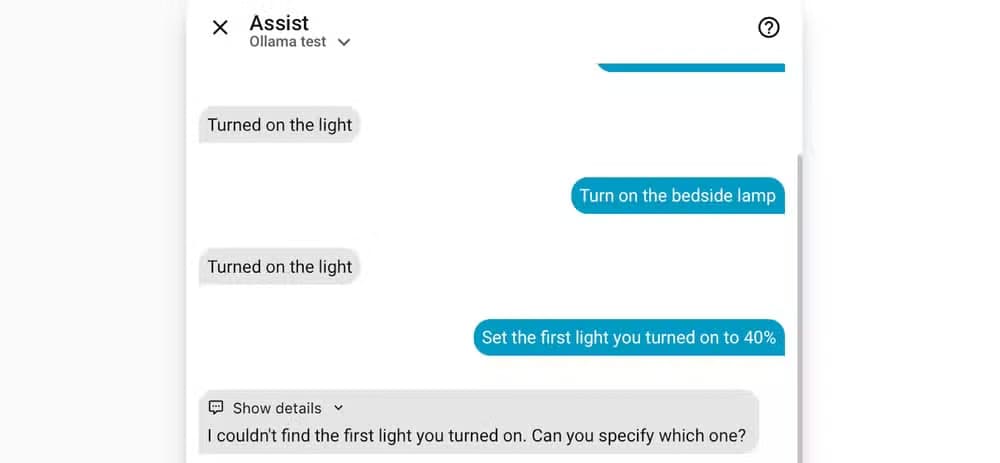
เนื่องจากรุ่น 4B ทำงานช้าเกินไป การทดสอบจึงเปลี่ยนไปใช้รุ่นที่เล็กกว่าเล็กน้อย คือ Llama 3.2 3B รุ่นนี้ทำงานได้แย่กว่าเดิม โดยใช้เวลาถึง 10 วินาทีในการปิดไฟอ่านหนังสือหลังจากคำสั่งง่ายๆ ซึ่งนานกว่า Qwen 3.5 เกือบสองเท่า และสำหรับคำสั่งที่ซับซ้อนกว่านั้น มันล้มเหลวทันทีโดยขอคำชี้แจงเพิ่มเติมเกี่ยวกับคำสั่งให้ตั้งค่าไฟดวงแรกที่เปิดเป็น 40%
Llama 3.2 3B แจ้งว่าไม่พบไฟดวงแรกที่เปิดใช้งานใน Assist ใน Home Assistant
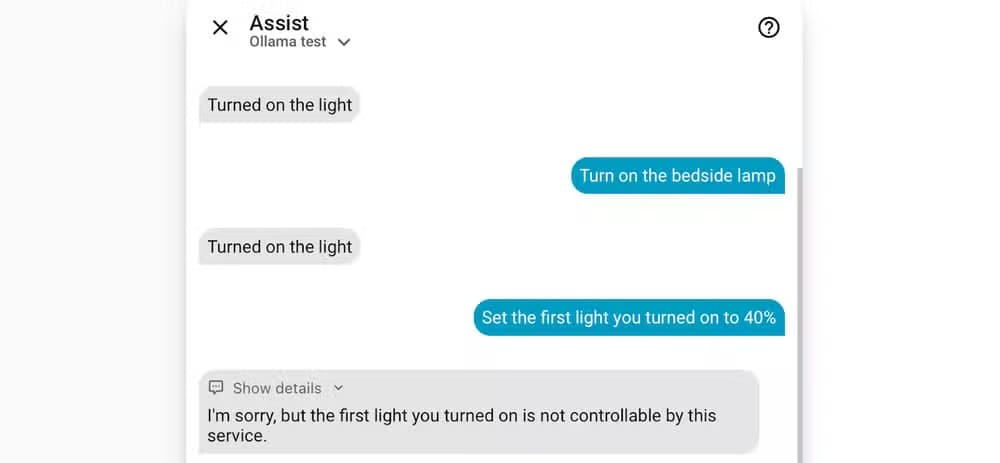
ถัดมาคือ Nemotron Mini 4B ซึ่งเป็นโมเดลภาษาขนาดเล็กจาก NVIDIA ที่ได้รับการปรับแต่งมาสำหรับการเรียกใช้ฟังก์ชัน ผลลัพธ์เบื้องต้นนั้นน่าประทับใจ โดยสามารถทำการทดสอบง่ายๆ "เปิดไฟอีกครั้ง" ได้ภายในเวลาประมาณสองวินาที อย่างไรก็ตาม มันล้มเหลวในการทดสอบที่ซับซ้อน เมื่อถูกขอให้ตั้งค่าไฟดวงแรกที่เปิดไว้ที่ 40% มันอ้างว่าไม่สามารถควบคุมแสงได้ ทั้งๆ ที่เพิ่งเปิดไฟไปเมื่อสักครู่
: Nemotron Mini 4B แจ้งว่าไฟที่เพิ่งเปิดนั้นไม่สามารถควบคุมได้ในแอป Assist ใน Home Assistant
ลองใช้ Granite 4 3B ดูสิ
ลำดับต่อไปคือการทดสอบ IBM Granite 4 3B รุ่นเล็กนี้ผ่านการทดสอบอย่างง่ายได้อย่างราบรื่นด้วยเวลาตอบสนองหนึ่งวินาที ซึ่งเร็วพอสำหรับผู้ช่วยเสียงได้อย่างสบายๆ
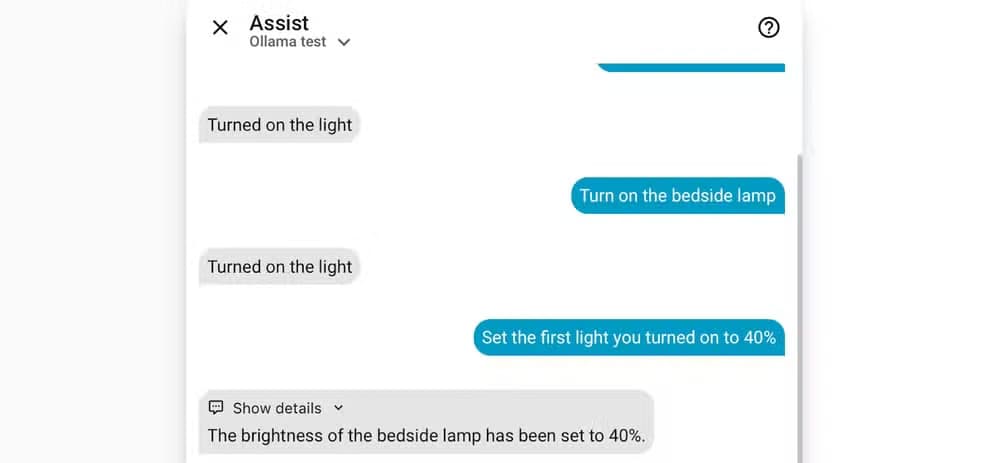
: Granite 4 3B ปิดไฟผิดดวงใน Assist ใน Home Assistant
น่าเสียดายที่มันไม่สามารถจัดการกับคำสั่งที่ซับซ้อนได้เช่นกัน เมื่อได้รับคำสั่งให้ปรับความสว่างของไฟดวงแรกที่เปิดอยู่เป็น 40% มันกลับไปปรับโคมไฟข้างเตียง (ไฟดวงที่สองที่เปิดอยู่) แทน แม้ว่ามันจะทำการเปลี่ยนแปลงทางกายภาพที่ถูกต้องกับไฟที่เพิ่งเปิดปิดไป แต่ก็ไม่สามารถระบุเป้าหมายที่ถูกต้องได้
Gemma 4 E2B แก้ปัญหาข้อจำกัดของระบบผู้ช่วยเสียงในพื้นที่
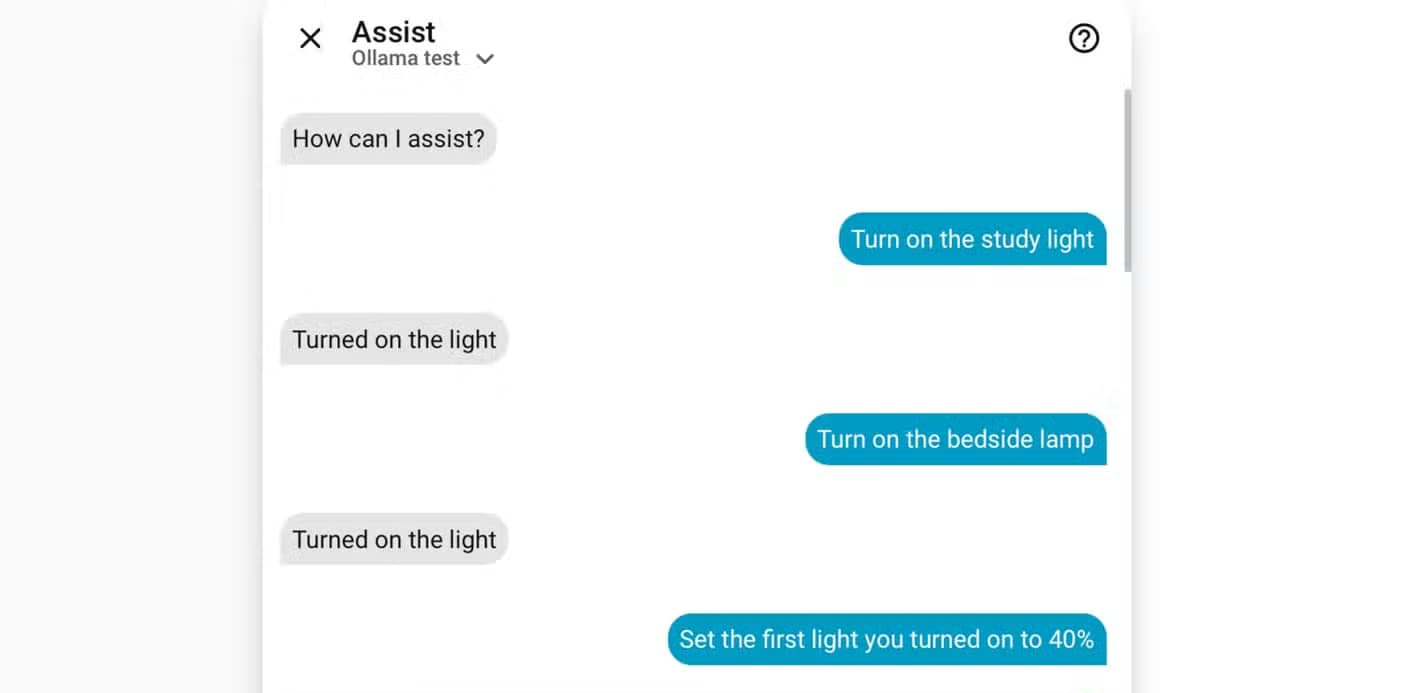
โมเดลสุดท้ายที่นำมาทดสอบคือ Gemma 4 E2B ซึ่งเป็นรุ่นที่เล็กที่สุดในตระกูล Gemma 4 ของ Google ตัวอักษร "E2B" ย่อมาจาก Effective 2 Billion parameters (พารามิเตอร์ที่มีประสิทธิภาพ 2 พันล้านตัว) แม้ว่ารุ่นเต็มจะมีขนาดใหญ่กว่า แต่การออกแบบนี้ช่วยให้การประมวลผลในระดับท้องถิ่นมีประสิทธิภาพสูง
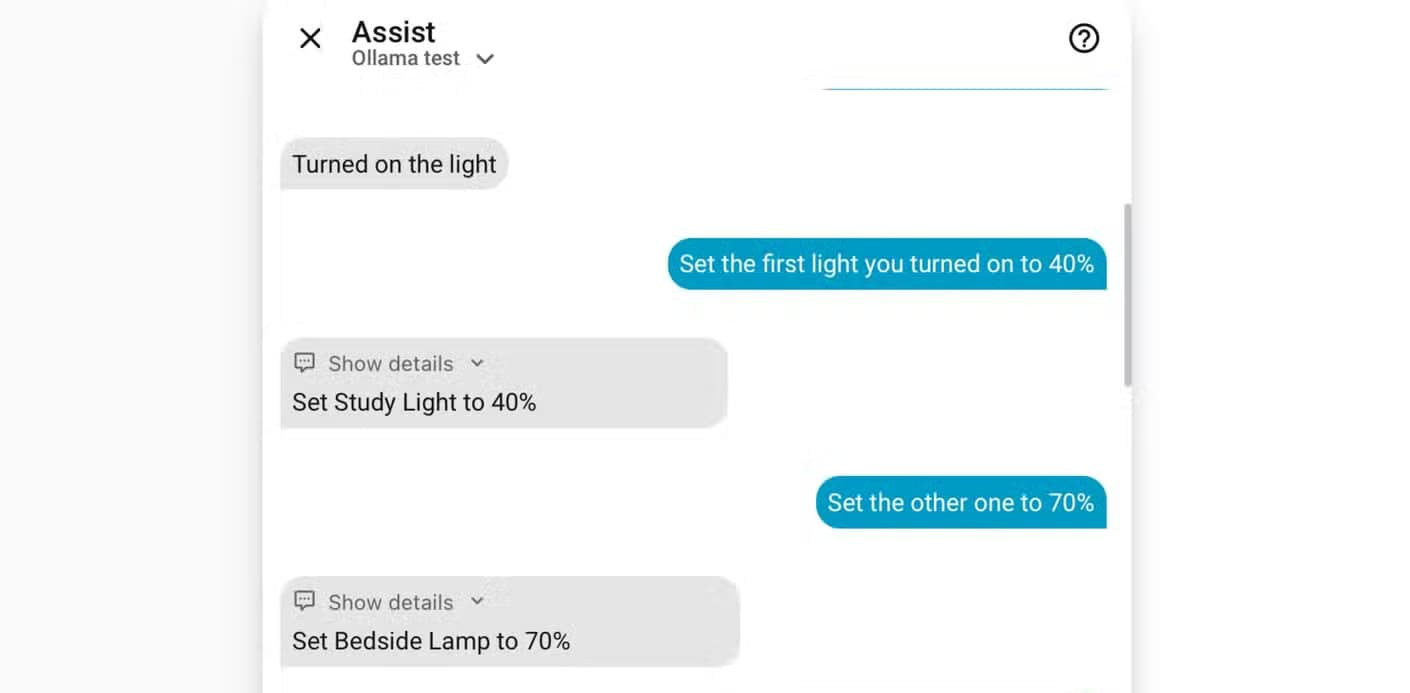
: ทดสอบระบบ Home Assistant Assist Ollama รุ่น Gemma 4 E2B โดยเปิดไฟอ่านหนังสือ จากนั้นเปิดไฟข้างเตียง และขอให้ตั้งค่าไฟดวงแรกเป็น 40 ไมโครเมตร
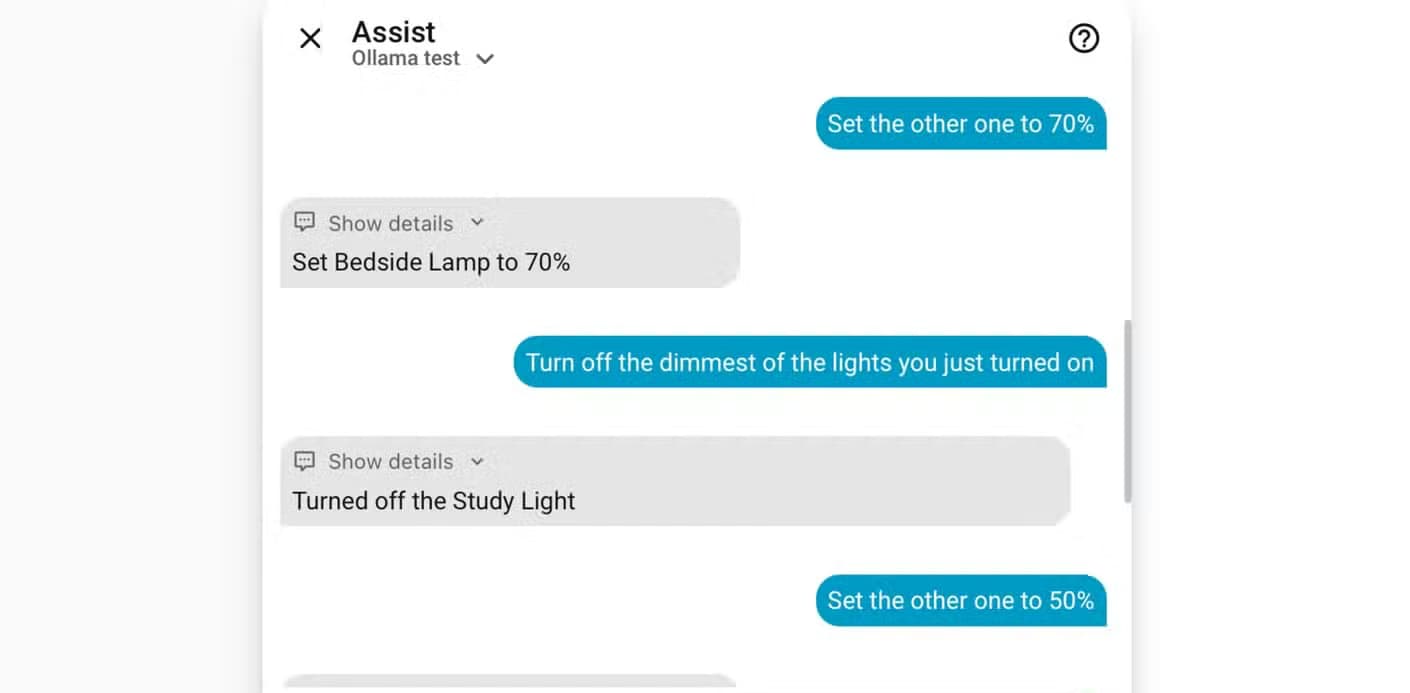
Gemma 4 E2B ผ่านการทดสอบอย่างง่าย โดยสามารถเปิดไฟได้ภายในเวลาประมาณหนึ่งวินาที จากนั้นก็ทำการทดสอบที่ซับซ้อนได้สำเร็จ โดยเข้าใจเจตนาในทุกขั้นตอนได้อย่างถูกต้อง และดำเนินการตามคำสั่งได้อย่างเหมาะสมด้วยเวลาตอบสนองที่ยอมรับได้
: ทดสอบระบบ Home Assistant Assist Ollama กับ Gemma 4 E2B โดยตั้งค่าไฟอ่านหนังสือเป็น 40 เปอร์เซ็นต์ และไฟข้างเตียงเป็น 70 เปอร์เซ็นต์อย่างถูกต้อง
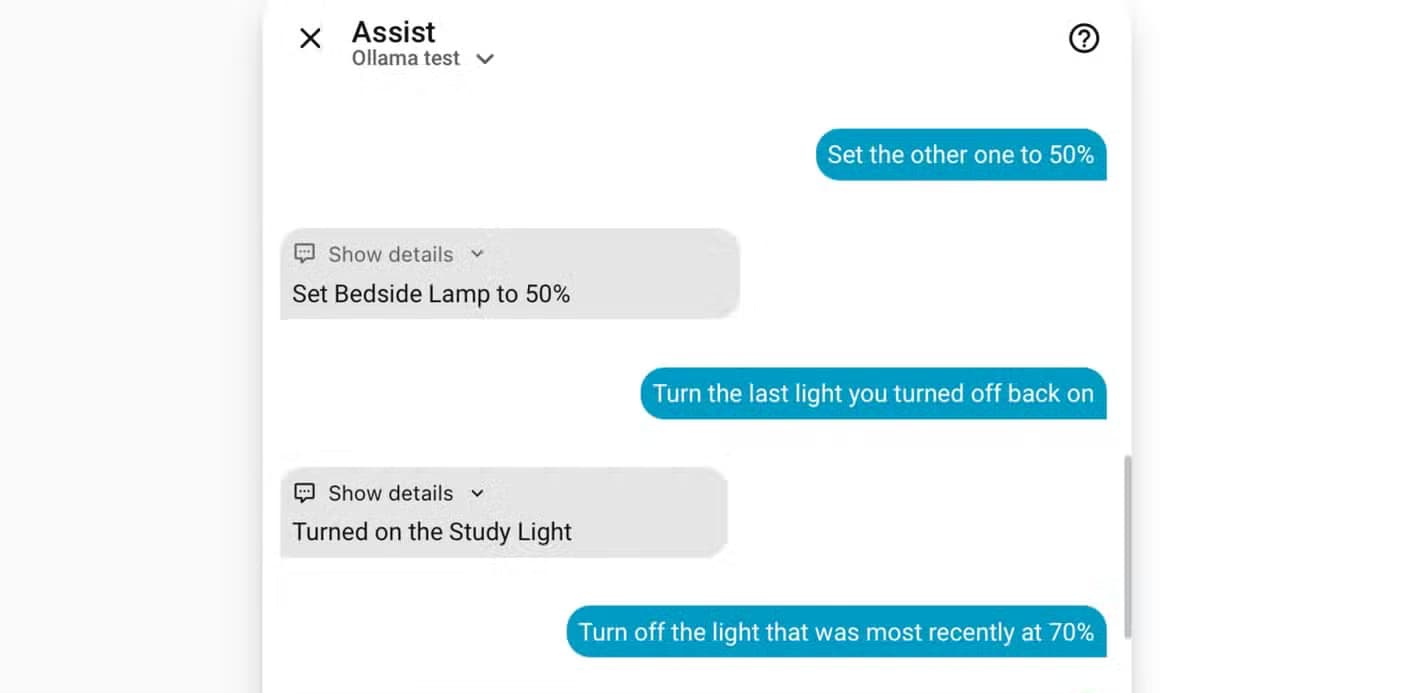
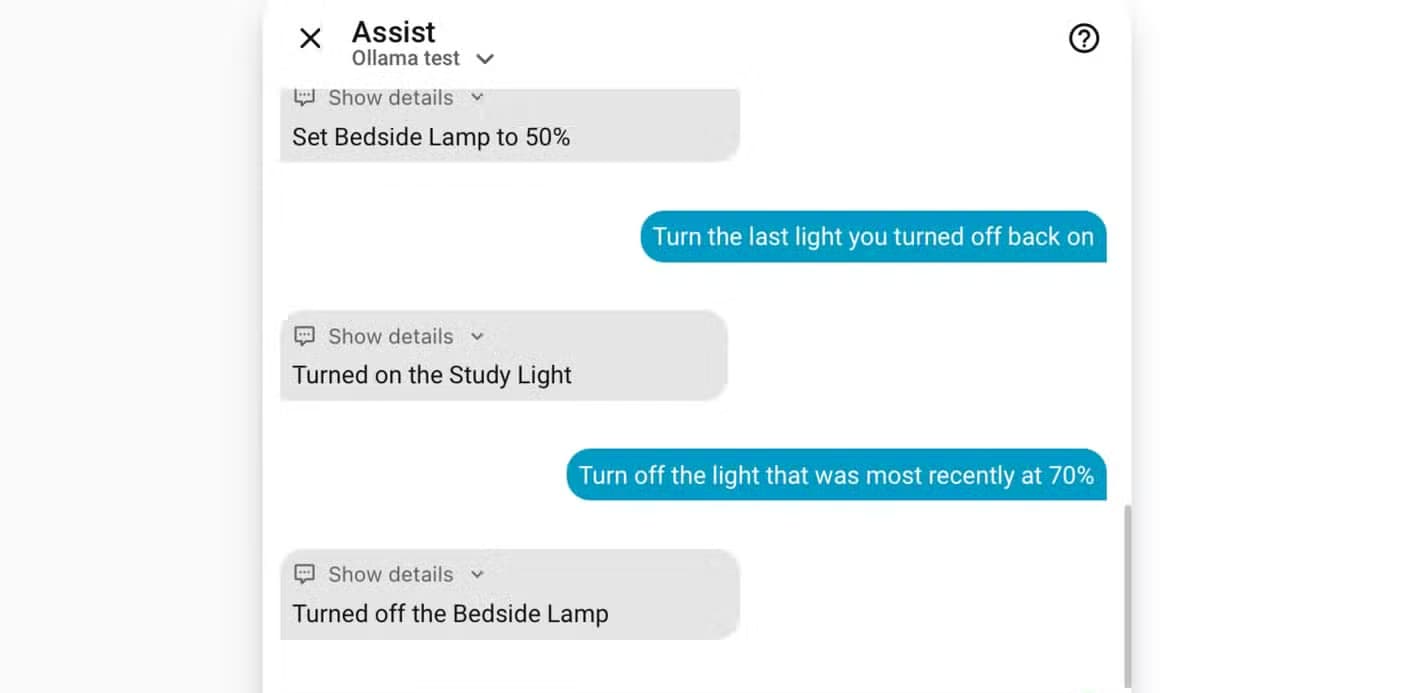
การทดสอบเพิ่มเติมพิสูจน์ให้เห็นถึงความน่าเชื่อถือในการสอบถามข้อมูลเชิงสัมพันธ์ เช่น การปิดไฟหรี่ หรือการเรียกคืนสถานะก่อนหน้า
: ทดสอบระบบ Home Assistant Assist Ollama กับ Gemma 4 E2B โดยระบบปิดไฟหรี่สำหรับอ่านหนังสือได้อย่างถูกต้อง เมื่อได้รับคำสั่งให้ปิดไฟที่หรี่ที่สุด
: ทดสอบระบบ Home Assistant Assist Ollama กับรุ่น Gemma 4 E2B ในการเปิดไฟอ่านหนังสืออีกครั้ง หลังจากที่ได้รับคำสั่งให้เปิดไฟดวงสุดท้ายที่ปิดไป
: ทดสอบระบบ Home Assistant Assist Ollama กับ Gemma 4 E2B โดยปิดไฟข้างเตียงอย่างถูกต้อง เนื่องจากระดับความสว่างล่าสุดถูกตั้งไว้ที่ 70 เปอร์เซ็นต์
สรุปผลการทดสอบ LLM ในท้องถิ่นที่ใช้ Home Assistant Assist
| ชื่อรุ่น | ความเร็วการทดสอบแบบง่าย | ความแม่นยำของเจตนาที่ซับซ้อน | ผลลัพธ์โดยรวม |
|---|---|---|---|
| Qwen 3.5 4B | 5 วินาที (ช้าเกินไป) | ล้มเหลว (เลือกไฟผิด) | ใช้การไม่ได้ |
| ลามะ 3.2 3บี | 10 วินาที (ช้ามาก) | ไม่ผ่าน (ขอคำชี้แจงเพิ่มเติม) | ใช้การไม่ได้ |
| เนโมตรอน มินิ 4B | 2 วินาที (เร็ว) | ล้มเหลว (อ้างว่าควบคุมแสงไม่ได้) | จำกัดเกินไป |
| แกรนิต 4 3B | 1 วินาที (เร็ว) | ล้มเหลว (เลือกไฟเป้าหมายผิด) | ดูดีมีอนาคตแต่กลับล้มเหลว |
| เจมม่า 4 E2B | 1 วินาที (เร็ว) | ผ่าน (เข้าใจเจตนารมณ์ทั้งหมด) | ประสบความสำเร็จ |
คำถามที่พบบ่อย
Home Assistant Assist คืออะไร?
Home Assistant Assist คือฟีเจอร์ผู้ช่วยเสียงในตัวของ Home Assistant ที่แปลงคำสั่งเสียงพูดให้เป็นการกระทำต่างๆ ในบ้านอัจฉริยะ
เหตุใดจึงควรใช้ LLM ในพื้นที่แทนที่จะใช้บริการคลาวด์สำหรับคำสั่งเสียง?
การใช้ LLM ในเครื่องผ่านเครื่องมืออย่าง Ollama จะช่วยเก็บคำสั่งเสียง ข้อมูลอุปกรณ์ และประวัติการทำงานอัตโนมัติทั้งหมดไว้เป็นส่วนตัวบนฮาร์ดแวร์ในเครื่องของคุณ แทนที่จะส่งไปยังเซิร์ฟเวอร์คลาวด์ของบุคคลที่สาม
เหตุใดระบบช่วยเหลืออัตโนมัติ (Assist) เวอร์ชันเริ่มต้นจึงมีปัญหาในการตอบสนองคำสั่งต่างๆ เช่น "ปิดอีกครั้ง"?
ระบบช่วยเหลือเริ่มต้น (Default Assist) อาศัยชุดประโยคและเจตนาที่กำหนดไว้ล่วงหน้าอย่างตายตัว เนื่องจากไม่มีสิ่งใดที่มีชื่อว่า "มัน" อย่างชัดเจน ระบบจึงไม่สามารถรับรู้บริบทการสนทนาได้หากไม่มี LLM (Linguical Language Management) คอยจัดการเจตนานั้น
Gemma 4 E2B ตอบสนองเร็วแค่ไหนระหว่างการทดสอบ?
Gemma 4 E2B สามารถทำเวลาตอบสนองได้ประมาณหนึ่งวินาทีบนฮาร์ดแวร์ภายในเครื่อง พร้อมทั้งรักษาความแม่นยำในการประมวลผลคำสั่งหลายขั้นตอนที่ซับซ้อนได้เป็นอย่างดี
E2B ใน Gemma 4 E2B ย่อมาจากอะไร?
E2B ย่อมาจาก Effective 2 Billion parameters ซึ่งแสดงถึงการออกแบบที่ช่วยให้โมเดลทำงานได้อย่างมีประสิทธิภาพมากกว่าที่ขนาดทางกายภาพโดยรวมอาจบ่งบอก